Harness Engineering na prática — o ambiente que você monta em volta do agente de código
No post sobre prompt, context e harness engineering eu separei as três camadas e falei do harness do ponto de vista de quem constrói um agente: idempotência, circuit breaker, gate de aprovação, audit trail.
Só que a maioria de nós não está construindo agente. Está usando um: Claude Code, OpenCode, Cursor, Codex. E aí surge a pergunta óbvia: se o harness da ferramenta já vem pronto, o que sobra pra mim?
Sobra muito. E é justamente a parte que mais muda o resultado no dia a dia.
Agente = modelo + harness
A definição que pegou em 2026 é simples: um agente é um modelo mais um harness. O harness é tudo que não é o modelo: o loop, as ferramentas, a gestão de contexto, as permissões, os sub-agentes, os pontos de extensão.
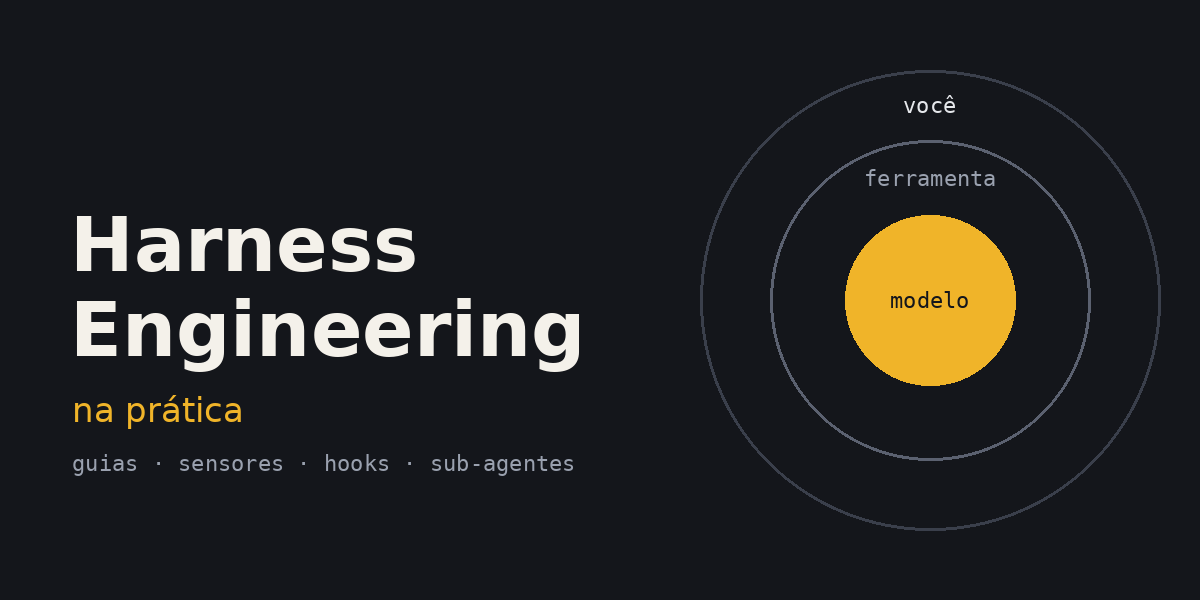
A Birgitta Böckeler, no artigo dela no site do Martin Fowler, propõe um modelo mental que eu acho muito útil: círculos concêntricos.
┌──────────────────────────────────────────────┐
│  Harness do usuário (você)                   │
│  AGENTS.md, skills, hooks, testes, lint,     │
│  sub-agentes, regras de arquitetura          │
│   ┌──────────────────────────────────────┐   │
│   │  Harness do construtor (a ferramenta)│   │
│   │  system prompt, loop, tools, busca   │   │
│   │   ┌──────────────────────────────┐   │   │
│   │   │           Modelo             │   │   │
│   │   └──────────────────────────────┘   │   │
│   └──────────────────────────────────────┘   │
└──────────────────────────────────────────────┘
O círculo do meio você não controla (ou controla pouco). O de fora é seu. E é ele que decide se o agente trabalha como alguém que conhece o projeto ou como um estagiário no primeiro dia.
Harness engineering, pra quem usa agente, é projetar esse círculo de fora.
Guias e sensores
A ideia central do artigo da Böckeler é que o harness tem dois tipos de controle:
- Guias (feedforward): agem antes do agente fazer algo. Aumentam a chance de ele acertar de primeira. AGENTS.md, convenções, skills, exemplos, templates.
- Sensores (feedback): agem depois. Observam o resultado e devolvem um sinal pro agente se corrigir. Testes, type-check, lint, análise estática, review.
E o ponto que muita gente perde: um sem o outro não funciona.
Só sensores: o agente repete os mesmos erros toda vez e corrige depois. Só guias: o agente segue regras, mas nunca descobre se deu certo.
Ela ainda divide os controles em computacionais (determinísticos, rápidos, baratos: linter, compilador, teste) e inferenciais (semânticos, feitos por outro modelo: review por agente, LLM-as-judge). Os computacionais são confiáveis e custam milissegundos. Os inferenciais pegam coisa que regra não pega, mas são mais caros e probabilísticos.
Regra prática: tudo que dá pra checar de forma determinística, cheque de forma determinística. Deixe o inferencial pro que sobra.
Guias: dê um mapa, não um manual
AGENTS.md curto, que aponta pra fora
O erro mais comum que eu vejo é o AGENTS.md (ou CLAUDE.md) gigante. Tudo que alguém lembrou de escrever foi parar lá. O resultado é um arquivo que ocupa contexto em toda sessão e que o modelo começa a ignorar.
O time da OpenAI que construiu um produto inteiro só com Codex chegou na mesma conclusão: eles trocaram o arquivo monolítico por um AGENTS.md de mais ou menos 100 linhas que funciona como índice. Ele diz onde olhar, e o conhecimento de verdade mora em docs/.
# AGENTS.md

## Comandos
- Instalar: `pnpm i`
- Testes: `pnpm test` (rode antes de dizer que terminou)
- Tipos: `pnpm typecheck`
- Lint: `pnpm lint`

## Onde está cada coisa
- Arquitetura e regras de dependência: `docs/arquitetura.md`
- Padrões de API e validação: `docs/api.md`
- Planos em andamento: `docs/planos/`
- Decisões passadas (ADRs): `docs/adr/`

## Regras que não mudam
- Nunca editar migrations existentes, só criar novas
- UI nunca importa de `src/repositories/` direto
- Não usar `any`; use `unknown` e valide
Curto, verificável e com ponteiros. O agente lê docs/api.md quando precisa mexer em API, e não em toda sessão. Isso é progressive disclosure aplicado ao seu repositório.
O que o agente não vê, não existe
Essa frase do post da OpenAI virou meu lema: do ponto de vista do agente, o que não está acessível no repositório não existe. A decisão de arquitetura que ficou numa thread do Slack, a convenção que "todo mundo sabe", o motivo daquele if estranho: nada disso existe pro agente.
Se o conhecimento importa, ele precisa estar no repo, em texto, num lugar que o AGENTS.md aponta.
Skills para processos repetidos
Skills (no Claude Code, OpenCode e outros) são pastas com instruções pra um tipo específico de tarefa: criar um endpoint, escrever uma migration, fazer release. A diferença pro AGENTS.md é que a skill só entra no contexto quando é relevante.
Se você explica a mesma coisa pro agente pela terceira vez, isso deveria virar uma skill.
Planos como artefato
Pra mudança grande, peça um plano antes e salve o plano no repo (docs/planos/migracao-auth.md). O plano vira um guia pras próximas sessões, sobrevive ao /clear e deixa claro o que foi decidido. A OpenAI trata planos como artefatos de primeira classe, versionados junto com o código.
Sensores: deixe o agente descobrir sozinho que errou
Aqui está, pra mim, a parte que mais rende. No post de Claude Code eu falei de dar critério de verificação no prompt ("rode npm test e corrija as falhas"). Sensores são o passo seguinte: o critério deixa de depender de você lembrar de pedir.
Hooks rodando sensores automaticamente
No Claude Code, um hook PostToolUse roda depois de cada edição. Se o script sair com código 2, o que ele escrever no stderr volta pro Claude como feedback, e ele corrige na hora.
// .claude/settings.json
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write|MultiEdit",
        "hooks": [
          { "type": "command", "command": ".claude/hooks/sensores.sh" }
        ]
      }
    ]
  }
}
#!/bin/bash
# .claude/hooks/sensores.sh

if ! OUT=$(pnpm -s typecheck 2>&1); then
  echo "Erros de tipo após sua edição. Corrija antes de continuar:" >&2
  echo "$OUT" | head -40 >&2
  exit 2
fi

if ! OUT=$(pnpm -s lint 2>&1); then
  echo "Lint falhou. Corrija antes de continuar:" >&2
  echo "$OUT" | head -40 >&2
  exit 2
fi

exit 0
O head -40 é proposital: saída de ferramenta também é contexto, e 2.000 linhas de erro poluem mais do que ajudam.
Se o type-check do projeto inteiro for lento, rode só nos arquivos alterados ou deixe o sensor pesado pro pre-commit. Sensor que demora 40 segundos a cada edição vira sensor que alguém desliga.
Mensagens de erro escritas pro agente
Esse é um detalhe que faz uma diferença enorme. Um sensor é muito mais útil quando a mensagem de erro já diz como corrigir. A OpenAI usa linters customizados cujas mensagens injetam instruções de correção direto no contexto do agente.
Dá pra fazer isso com o que você já tem. Por exemplo, com no-restricted-imports no ESLint:
// eslint.config.js
export default [
  {
    files: ['src/ui/**/*.{ts,tsx}'],
    rules: {
      'no-restricted-imports': ['error', {
        patterns: [{
          group: ['**/repositories/*'],
          message:
            'UI não acessa repositório direto. Use o service correspondente em ' +
            'src/services/ (veja docs/arquitetura.md, seção "Camadas").',
        }],
      }],
    },
  },
]
O agente erra, o lint aponta, e a própria mensagem explica o caminho certo. Você não precisou estar lá.
Regras de arquitetura como teste
Regra de arquitetura que só existe em documento é sugestão. Pra virar regra, precisa de sensor. Alguns que funcionam bem:
- Imports circulares:
madge --circularno CI (escrevi sobre isso aqui). - Fronteiras entre camadas:
no-restricted-imports, dependency-cruiser ou testes de estrutura. - Limites simples: tamanho máximo de arquivo, proibição de
console.log, logging estruturado obrigatório.
O artigo da Böckeler chama isso de architecture fitness harness: funções que definem e checam características da arquitetura.
Sensores inferenciais: um agente revisando o outro
Pra o que regra não pega (overengineering, nome ruim, lógica que não faz sentido pro domínio), use review por outro agente, de preferência com contexto limpo, que não viu a implementação sendo feita. Um sub-agente de review ou a GitHub Action que mostrei no post de Claude Code resolvem bem.
Só não esqueça que é probabilístico. Ele filtra, mas não garante.
Deixe a aplicação legível pro agente
Outra lição forte do relato da OpenAI: o gargalo deixou de ser o modelo e passou a ser o que o agente consegue observar. Eles fizeram a aplicação subir isolada em cada git worktree, deram acesso a logs e métricas locais e integraram o Chrome DevTools pra o agente ver a UI de verdade.
Você não precisa chegar nesse nível, mas dá pra começar pequeno:
- Um comando único pra subir o app localmente (
pnpm dev) documentado no AGENTS.md. - Logs legíveis no terminal, não só num serviço externo.
- Acesso ao navegador (MCP do Playwright, Chrome DevTools ou o browser da própria ferramenta) pra validar mudanças de UI.
- Seed de banco reproduzível pra reproduzir bug.
Quanto mais o agente consegue reproduzir e verificar sozinho, menos você vira o único feedback loop.
Sub-agentes e o modelo certo pra cada tarefa
Nem toda tarefa precisa do modelo mais caro. Explorar o codebase, gerar título de sessão, resumir histórico, compactar contexto: tudo isso funciona bem com um modelo menor e mais rápido.
No OpenCode, por exemplo, dá pra definir o modelo por agente no opencode.json:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "anthropic/claude-sonnet-5-5",
  "small_model": "anthropic/claude-haiku-4-5",
  "agent": {
    "explore":    { "model": "anthropic/claude-haiku-4-5" },
    "title":      { "model": "anthropic/claude-haiku-4-5" },
    "summary":    { "model": "anthropic/claude-haiku-4-5" },
    "compaction": { "model": "anthropic/claude-haiku-4-5" }
  }
}
explore é o sub-agente de leitura e busca. title, summary e compaction são agentes de sistema ocultos que geram título, resumo e compactam o contexto quando a conversa cresce. Confira os IDs disponíveis com opencode models e a documentação de agentes da sua versão, porque a estrutura mudou na V2.
No Claude Code, a mesma ideia vira um arquivo em .claude/agents/:
---
name: explorador
description: Investiga o codebase e devolve um resumo curto. Use antes de mudanças grandes.
tools: Read, Grep, Glob
model: haiku
---

Você investiga código e nunca edita nada.
Responda com no máximo 400 palavras: arquivos relevantes, fluxo principal,
pontos de risco. Cite caminhos de arquivo.
O ganho é duplo: custo menor e contexto limpo na sessão principal, porque o sub-agente lê 30 arquivos e devolve só o resumo.
A regra de ouro: erro do agente vira melhoria no harness
Se você levar uma coisa só deste artigo, leve essa.
Quando o agente erra, a reação natural é corrigir o código e seguir. Funciona, mas o mesmo erro volta amanhã, em outra sessão, com outra pessoa do time.
A Böckeler chama isso de steering loop: sempre que um problema acontece mais de uma vez, você melhora um guia ou um sensor pra que ele fique menos provável, ou impossível.
| O agente... | Corrija o código e... |
|---|---|
| Importou o repositório direto na UI | Adicione no-restricted-imports com mensagem de correção |
| Esqueceu de rodar os testes | Hook PostToolUse ou instrução explícita no AGENTS.md |
| Editou uma migration existente | Regra de deny no settings + linha no AGENTS.md |
| Criou ciclo de import | madge --circular no pre-commit / CI |
| Fez o mesmo setup errado pela terceira vez | Transforme em skill |
| Não sabia de uma decisão de arquitetura | Escreva o ADR em docs/adr/ e aponte no AGENTS.md |
E o melhor: o próprio agente ajuda a construir o harness. Peça pra ele escrever a regra de lint, o teste de estrutura ou o rascunho do ADR. Você revisa.
O harness também apodrece
Harness é código. E código sem manutenção apodrece.
AGENTS.md com comando que não existe mais, regra que contradiz outra, skill que descreve um fluxo antigo, sensor que todo mundo ignora porque sempre falha. Tudo isso faz o agente piorar sem que ninguém perceba por quê.
O time da OpenAI chama a solução de garbage collection: tarefas recorrentes que procuram desvios dos princípios do projeto e abrem PRs de correção pequenos, em vez de deixar a dívida acumular. Pra um time normal, uma revisão periódica do AGENTS.md, das skills e dos hooks já resolve boa parte.
Por onde começar
Se o seu projeto hoje tem só um CLAUDE.md genérico, essa é a ordem que eu sugiro:
- AGENTS.md curto com comandos, onde está cada coisa e as poucas regras que não mudam.
- Um sensor rápido no loop: type-check + lint via hook depois de cada edição.
- Mensagens de erro com instrução de correção nas regras que mais quebram.
- Uma regra de arquitetura como teste (comece por imports circulares ou fronteira UI → repositório).
- Sub-agente de exploração com modelo menor.
- O hábito: todo erro repetido vira guia ou sensor.
Nada disso substitui revisar o que vai pro repositório. Um bom harness não elimina o humano do processo; ele direciona a sua atenção pra onde ela realmente importa.
Conclusão
Prompt engineering é sobre o que você pede. Context engineering é sobre o que o modelo vê. Harness engineering, do lado de quem usa agente, é sobre o ambiente em que ele trabalha: o que ele sabe antes de começar e o que ele descobre depois de agir.
- Guias aumentam a chance de acertar de primeira.
- Sensores fazem o agente descobrir sozinho que errou.
- Computacional primeiro, inferencial pro que sobra.
- Repositório como fonte da verdade: o que o agente não vê, não existe.
- Todo erro repetido vira melhoria no harness, não só uma correção pontual.
O modelo vai continuar melhorando, e você não controla isso. O harness é a parte que você controla. E é ela que separa o agente que "às vezes acerta" do agente em que você confia pra trabalhar enquanto faz outra coisa.
Referências
- Harness engineering for coding agent users — Birgitta Böckeler (martinfowler.com)
- Harness engineering: leveraging Codex in an agent-first world — OpenAI
- SE Radio 730 — Birgitta Böckeler on Harness Engineering for AI Agents
- Harness engineering: What makes AI coding agents work in 2026 — Faros AI
- OpenCode — Agents
- Claude Code — Hooks
- Claude Code — Subagents
- Você não tem problema de prompt — tem problema de contexto ou de harness
- Claude Code na prática — guia real para desenvolvimento de software